اولین گراف دانش خط میخی پارسی باستان
شرکت دانشبنیان آریا هامان مهر پارسه با افتخار اعلام میکند که «گراف دانش خط میخی پارسی باستان» را بهعنوان نخستین پایگاه دانش یکپارچه، شواهدمحور و هوشمصنوعیپشتیبانِ اختصاصیافته به زبان و خط میخی پارسی باستان توسعه داده و در دسترس پژوهشگران، دانشجویان، مدرسین، علاقهمندان تاریخ ایران و کاربران عمومی قرار داده است.
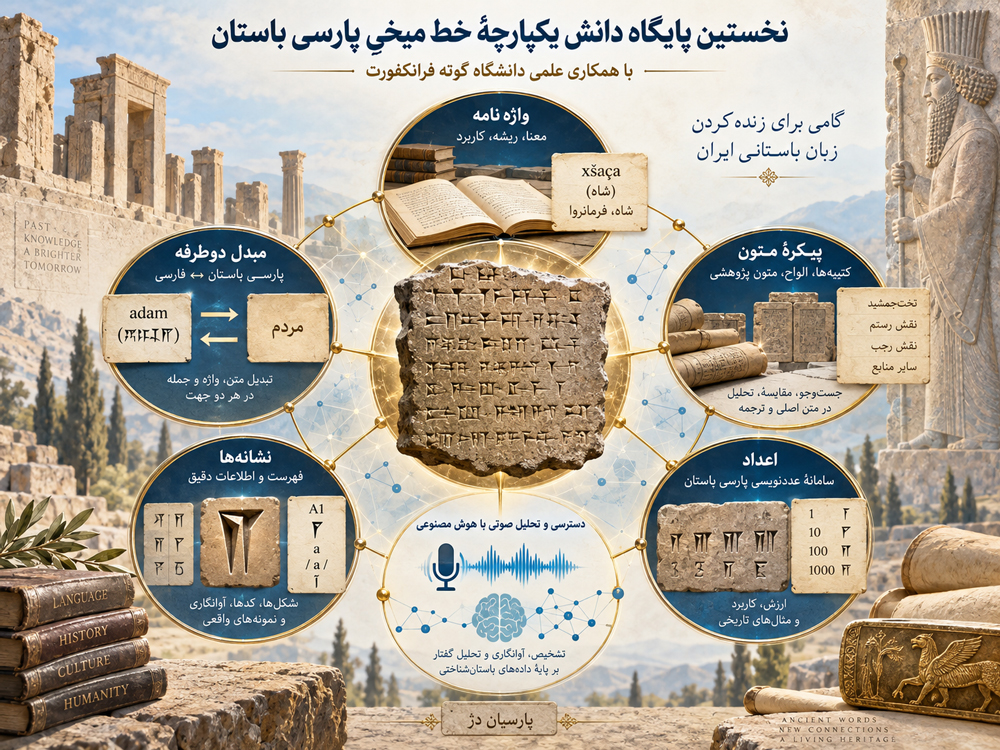
گراف دانش خط میخی پارسی باستان - پارسیان دژ یک فرهنگ واژه یا پیکرهٔ متنی منفرد نیست؛ بلکه محیطی پژوهشی است که در آن نشانههای میخی، ارزشهای خوانش، واژهها، صورتهای صرفی، رخدادهای کتیبهای، خطوط، کتیبهها، اعداد، منابع علمی، روشهای تطبیق، سطح اطمینان، وضعیت بازبینی و خوانشهای صوتی در قالب یک شبکهٔ دانشی به یکدیگر متصل شدهاند.
همکاری علمی، استفادهٔ مجاز از دادههای TITUS و قدردانی رسمی
پیکرهٔ پارسی باستان TITUS یکی از منابع علمی و زبانشناختی مهم اولین گراف دانش خط میخی پارسی باستان - پارسیان دژ است. استفاده از دادههای TITUS برای ذخیرهسازی، پردازش و نمایش عمومی غیرتجاری در پارسیان دژ با اجازهٔ کتبی پروژهٔ TITUS انجام شده است.
شرکت دانشبنیان آریا هامان مهر پارسه مراتب سپاس خود را از پروفسور یوست گیپرت برای اعطای اجازهٔ استفاده از دادههای پیکرهٔ پارسی باستان TITUS و ارائهٔ بازخورد علمی ارزشمند اعلام میکند. همچنین از پروژهٔ TITUS، تمامی مشارکتکنندگان آن و دانشگاه گوته فرانکفورت برای نقشی که در دسترسپذیر ساختن این منابع زبانشناختی برای مطالعه و آموزش داشتهاند، قدردانی میکنیم.
در نسخهٔ عمومی، این مجموعه شامل ۱٬۳۱۶ مدخل منتشرشده در فرهنگ واژه، ۱۴۳ کتیبه و ۱٬۶۲۷ خط در پیکره، ۵۰ نشانهٔ رسمی Unicode و پنج نشانهٔ عددی پارسی باستان است. مبدل دوطرفهٔ سامانه نیز نتایج را نه بهصورت یک خروجی صرف، بلکه همراه با مدخلهای مرتبط، گواههای کتیبهای، نوع تطبیق، سطح اطمینان و تحلیل نشانهبهنشانه ارائه میکند.
دو فناوری هوش مصنوعی اختصاصی شرکت، نقش مهمی در گسترش این زیرساخت دارند:
- هوش مصنوعی زال برای تحلیل دادههای خط میخی پارسی باستان و تقویت لایهٔ شناختی و زبانشناختی گراف دانش؛
- هوش مصنوعی هامان آوا برای در دسترس قرار دادن خوانش صوتی واژهها، خطوط و کتیبهها، همراه با اعلام صوتی بخشهای افتاده، ناخوانا یا بازسازیشده.
شرکت دانشبنیان آریا هامان مهر پارسه همچنین اعلام میکند که نسل بعدی خروجیهای زال و هامان آوا، پس از تکمیل ارزیابیهای فنی و پژوهشی، بهزودی با کیفیت و قابلیتهای بهبودیافتهتری در اختیار محققان قرار خواهد گرفت.
از سنگنوشته تا صدا؛ گامی برای زندهکردن زبان باستانی ایران
شرکت دانشبنیان آریا هامان مهر پارسه با افتخار اعلام میکند که پس از سالها فعالیت در حوزهٔ پژوهش تاریخی، پردازش زبان، تحلیل داده، مهندسی دانش و هوش مصنوعی، زیرساخت پژوهشی «اولین گراف دانش خط میخی پارسی باستان» را برای مطالعهٔ دیجیتال زبان و خط میخی پارسی باستان توسعه داده است.
پارسیان دژ برای ما تنها یک وبسایت یا مجموعهای از ابزارهای پراکنده نیست. این پروژه (اولین گراف دانش خط میخی پارسی باستان) تلاشی بلندمدت برای تبدیل بخشی از میراث نوشتاری ایران به زیرساختی زنده، متصل، قابل جستوجو، قابل ارزیابی و توسعهپذیر است؛ زیرساختی که بتواند فاصلهٔ میان متن باستانی، پژوهش زبانشناختی، فناوری دیجیتال و مخاطب امروز را کاهش دهد.
فعالیت پژوهشی شرکت با پارسیان دژ از سال ۱۳۹۰ آغاز شده و در ادامه با گسترش فعالیتهای پردازش زبان طبیعی، تحلیل کلانداده و توسعهٔ محصولات هوش مصنوعی فارسیمحور به یکی از محورهای اصلی فعالیت آریا هامان مهر پارسه تبدیل شده است. شرکت آریا هامان مهر پارسه یک شرکت دانشبنیان نرمافزاری است که بر محصولات فارسیمحور، زیرساختهای هوش مصنوعی، گراف دانش و ابزارهای پژوهشی و دانشی تمرکز دارد.
مسئلهای که به شکلگیری نخستین گراف دانشِ خط میخی پارسی باستان انجامید
مطالعهٔ پارسی باستان معمولاً پژوهشگر را با چند منبع جدا از یکدیگر روبهرو میکند. متن کتیبه ممکن است در یک پیکره قرار داشته باشد، معنی واژه در یک فرهنگ دیگر، مشخصات Unicode در جدولی جداگانه، تحلیل نشانهها در یک منبع تخصصی، تصویر کتیبه در یک مجموعهٔ تصویری و خوانش یا تلفظ تقریبی آن در منبعی دیگر.
این پراکندگی باعث میشود پاسخ به یک پرسش ساده، مانند «این واژه در کدام کتیبهها آمده است؟»، به مراجعهٔ همزمان به چند منبع نیاز داشته باشد. پرسشهای عمیقتر دشوارتر میشوند:
- این صورت میخی از چه نشانههایی ساخته شده است؟
- هر نشانه چه ارزش خوانشی و چه کد Unicode دارد؟
- این واژه دقیقاً در کدام خطوط کتیبهها ثبت شده است؟
- تطبیق واژه با مدخل فرهنگ، دقیق، استنباطی یا تقریبی بوده است؟
- داده از کدام منبع به دست آمده است؟
- چه پردازشی روی داده انجام شده است؟
- آیا نتیجه بازبینی انسانی شده یا هنوز ماشینی است؟
- آیا بخشی از متن افتاده، آسیبدیده یا بازسازیشده است؟
- خوانش صوتی چگونه این عدمقطعیتها را به شنونده منتقل میکند؟
پارسیان دژ برای پاسخ به همین مسئله طراحی شده است: تبدیل منابع پراکنده به یک شبکهٔ دانشی واحد، بدون از میان بردن تفاوت میان دادهٔ منبع، پردازش ماشینی و داوری پژوهشی.
گراف دانش خط میخی پارسی باستان بهعنوان یک پایگاه دانش یکپارچه و شواهدمحور
منظور ما از «پایگاه دانش» صرفاً پایگاهی برای ذخیرهٔ متن نیست. در گراف دانش خط میخی پارسی باستان، هر موجودیت پژوهشی میتواند به موجودیتهای دیگر متصل شود. بهصورت ساده، بخشی از زنجیرهٔ روابط سامانه چنین است:
نشانهٔ میخی ← ارزش خوانش ← صورت نوشتاری ← واژه یا لم ← رخداد واژه در پیکره ← خط کتیبه ← کتیبه ← فرمانروا، مکان و منبع
در کنار این زنجیره، روابط دیگری نیز نگهداری میشوند:
روش تطبیق ← سطح اطمینان ← وضعیت بازبینی ← نسخهٔ پردازش ← اثرانگشت منبع ← وضعیت آسیب یا بازسازی ← خوانش صوتی
در نتیجه، یک واژه در گراف دانش خط میخی پارسی باستان فقط یک معنی نیست. واژه به شکل میخی، نویسهگردانی، آوانویسی، اجزای نشانهای، نمونههای کاربرد در کتیبهها، منابع، وضعیت بازبینی، تصویر و صوت متصل است.
همچنین یک خط کتیبه تنها یک رشتهٔ متنی نیست؛ بلکه یک رکورد پژوهشی شامل متن میخی، نویسهگردانی، خوانش، قطعهبندی، مدخلهای واژهنامهای، وضعیت ویراستاری، سطح اطمینان، ترجمه یا معنی تولیدشده و نسخهٔ پردازش است.
این معماری سبب شده است که کاربر بتواند از سطح یک نشانه به واژه، از واژه به شاهد کتیبهای، از شاهد به خط، از خط به کتیبه و دوباره از کتیبه به تحلیل واژگانی و صوتی بازگردد.
گراف دانش خط میخی پارسی باستان؛ از ذخیرهٔ اطلاعات تا فهم روابط
هستهٔ ارتباطی گراف دانش خط میخی پارسی باستان پارسیان دژ بر پایهٔ رویکرد گراف دانش شکل گرفته است. در این رویکرد، دادهها تنها در جدولها یا صفحات جداگانه قرار نمیگیرند؛ بلکه میان آنها روابط معنادار برقرار میشود.
برای نمونه، سامانه میتواند میان موجودیتهای زیر ارتباط برقرار کند:
- یک نشانه و ارزش خوانشی آن؛
- یک نشانه و واژههایی که در ساخت آنها حضور دارد؛
- یک واژه و صورتهای ثبتشدهٔ آن؛
- یک واژه و رخدادهایش در خطوط کتیبهها؛
- یک رخداد و روش شناسایی یا تطبیق آن؛
- یک خط و وضعیت حفظشدگی یا بازسازی آن؛
- یک خط و ترجمه یا توضیح ماشینی مربوط به آن؛
- یک کتیبه و فرمانروا، مکان، شناسه و منبع علمی آن؛
- یک فایل صوتی و متن، نسخه و وضعیت پژوهشیای که از روی آن تولید شده است.
این مدل، امکان عبور از جستوجوی سادهٔ رشتههای متنی به سمت مطالعهٔ موجودیتها، روابط، تکرارها، زمینهها و الگوهای مفهومی را فراهم میکند.
گراف دانش خط میخی پارسی باستان پارسیان دژ همچنین زمینهای برای تحلیلهای آینده مانند بررسی همرخدادی واژهها، مطالعهٔ شبکههای مفهومی، مقایسهٔ کاربرد واژگان در دورهها و فرمانرواییهای مختلف، تحلیل ساختارهای تکرارشونده و ارزیابی پیوندهای میان صورت نوشتاری و بافت کتیبهای فراهم میسازد.
پنج بخش اصلی گراف دانش خط میخی پارسی باستان پارسیان دژ
۱. فرهنگ واژهٔ شواهدمحور پارسی باستان
فرهنگ واژهٔ خط میخی پارسی باستان پارسیان دژ در نسخهٔ عمومی بررسیشده شامل ۱٬۳۱۶ مدخل منتشرشده است. جستوجو در این فرهنگ تنها به معنی انگلیسی محدود نیست و میتواند بر اساس صورت میخی، نویسهگردانی، معنی، نوع مدخل، وضعیت علمی و حتی شناسهٔ کتیبه انجام شود.
نوآوری اصلی این بخش، تبدیل هر مدخل به یک پروندهٔ پژوهشی متصل است. یک مدخل میتواند شامل موارد زیر باشد:
- شکل میخی؛
- لم یا صورت پایه؛
- نویسهگردانی علمی؛
- آوانویسی یا خوانش؛
- معنی؛
- شناسهٔ پایدار؛
- تحلیل نشانهبهنشانه؛
- خوانش صوتی؛
- تصویر دارای منبع و مجوز؛
- گواههای کتیبهای؛
- محل دقیق رخداد؛
- دامنهٔ توکن؛
- روش تطبیق؛
- سطح اطمینان؛
- وضعیت نیاز به بازبینی؛
- ارجاعات علمی.
برای نمونه، مدخل «داریوش» در گراف دانش خط میخی پارسی باستان پارسیان دژ شکل میخی، لم، نویسهگردانی، آوانویسی، تحلیل هفت نشانهٔ سازنده، خوانش صوتی، تصویر دارای اطلاعات پدیدآورنده و مجوز و ۱۷۵ رخداد در خطوط کتیبهها را به یکدیگر متصل میکند. رخدادهای پیکرهای نیز همراه با محل، دامنهٔ توکن، نوع تطبیق، درصد اطمینان و وضعیت بازبینی نمایش داده میشوند.
به این ترتیب، فرهنگ واژه از حالت یک فهرست معنی خارج شده و به رابطی برای ورود به کل شبکهٔ شواهد تبدیل شده است.
۲. مبدل دوطرفه و شواهدمحور خط میخی پارسی باستان
مبدل خط میخی پارسیان دژ سه مسیر پژوهشی اصلی را ارائه میکند:
- جستوجوی معنی انگلیسی و بازیابی صورتهای مستند پارسی باستان؛
- تبدیل نویسهگردانی علمی به خط میخی؛
- خواندن ورودی میخی و بازیابی مدخلها و معنیهای مرتبط.
این ابزار نشانههای آوایی، واژهنگارها، جداکنندهٔ واژه و پنج نشانهٔ عددی را پشتیبانی میکند. کاربر همچنین به نویسههای علمی لازم برای وارد کردن صورتهای پارسی باستان دسترسی دارد.
وجه متمایز مبدل پارسیان دژ آن است که نتیجه را بدون شواهد رها نمیکند. خروجی میتواند شامل موارد زیر باشد:
- شکل میخی؛
- نویسهگردانی؛
- معنی واژهنامهای؛
- تطبیق دقیق یا نزدیک؛
- تعداد رخدادهای مستند؛
- فهرست نمونههای کتیبهای؛
- سطح اطمینان؛
- مدخل فرهنگ واژه؛
- تحلیل نشانهبهنشانه؛
- واژههای حلنشده؛
- نسخهٔ قاعده یا parser؛
- نسخهٔ انتشار پیکره؛
- اثرانگشت منبع؛
- وضعیت ترجمه و بازبینی.
برای نمونه، جستوجوی معنی «king» صورت مستند xšāyaθiya را همراه با شکل میخی، مدخل فرهنگ، تحلیل نشانهها و ۴۵۶ رخداد مستند در انتشار فعال پیکره نمایش میدهد. سامانه میان تطبیق دقیق، پیشنهاد نزدیک و تقریب آوایی تفاوت قائل میشود و تقریب آوایی را بهجای شاهد تاریخی معرفی نمیکند.
بنابراین، مبدل خط میخی پارسی باستان - پارسیان دژ فقط یک ابزار تایپ یا تبدیل Unicode نیست؛ بلکه یک مبدل پژوهشی مبتنی بر شواهد است.
۳. پیکرهٔ جستوجوپذیر و قابلممیزی کتیبههای خط میخی پارسی باستان
نسخهٔ عمومی پیکرهٔ خط میخی پارسی باستان - پارسیان دژ شامل ۱۴۳ رکورد کتیبه و ۱٬۶۲۷ خط منتشرشده است. کاربر میتواند بر اساس شناسه، عنوان، مکان، واژه، نشانه یا عبارت جستوجو کند و نتایج را بر پایهٔ کتیبه، لایهٔ متن، نوع تطبیق و وضعیت ویراستاری پالایش کند.
هر خط میتواند چند لایه را در کنار یکدیگر نمایش دهد:
- متن میخی؛
- نویسهگردانی؛
- آوانویسی یا خوانش؛
- معنی یا ترجمهٔ تولیدشده؛
- وضعیت ویراستاری؛
- توکنهای سازنده؛
- واژهنگارها و اعداد؛
- مدخلهای فرهنگ مرتبط؛
- وضعیت حلشدگی واژهها؛
- سطح اطمینان؛
- نسخهٔ پردازش؛
- ارجاع به متن منبع.
یکی از اصول مهم این پیکره، جدا نگه داشتن متن دریافتشده از منبع از لایههای افزودهشده توسط پارسیان دژ است. متن میخی، نویسهگردانی، آوانویسی، شناسهها و محل خطوط بهعنوان لایهٔ منبع حفظ میشوند؛ نرمالسازی فنی، توکنسازی، پیوندهای واژهنامهای، توضیحات تولیدشده و اصلاحات محلی در لایههای جداگانه قرار میگیرند.
این جداسازی باعث میشود پژوهشگر بتواند ببیند چه بخشی از داده از منبع علمی دریافت شده، چه بخشی حاصل پردازش فنی است، چه بخشی توسط سامانه استنباط شده و کدام بخش به بازبینی انسانی نیاز دارد.
۴. نشانهنامهٔ Unicode مبتنی بر شواهد پیکرهای
نشانهنامهٔ خط میخی پارسی باستان پارسیان دژ ۵۰ نشانهٔ رسمی خط میخی پارسی باستان را پوشش میدهد. هر نشانه با اطلاعاتی مانند کد Unicode، نام رسمی، نوع نشانه، ارزش خوانش و امکان انتقال مستقیم به مبدل ارائه میشود. جستوجو نیز بر اساس شکل نشانه، نام، کد یا ارزش خوانشی انجامپذیر است.
استاندارد Unicode برای خط پارسی باستان، نشانههای آوایی، واژهنگارها، جداکنندهٔ واژه و اعداد را در محدودهٔ مربوط تعریف کرده است. پارسیان دژ این استاندارد را به لایهٔ پژوهشی و پیکرهای متصل میکند؛ به این معنا که نشانه فقط بهعنوان یک کد رایانهای معرفی نمیشود، بلکه میتواند به نمونههای واقعی استفادهٔ خود در کتیبهها، واژههای سازنده و مبدل متصل شود.
تفاوت اصلی نشانهنامهٔ پارسیان دژ با یک جدول ساده در همین اتصال است:
کد Unicode ← نشانه ← ارزش خوانش ← نوع نشانه ← کاربرد در واژه ← رخداد در کتیبه
این ساختار برای آموزش، بررسی املا، پردازش رایانهای، مطالعهٔ بسامد نشانهها و تحلیل ساخت واژهها کاربرد دارد.
۵. سازنده و تحلیلگر اعداد پارسی باستان
بخش اعداد خط میخی پارسی باستان - پارسیان دژ پنج نشانهٔ عددی رسمی با ارزشهای ۱، ۲، ۱۰، ۲۰ و ۱۰۰ را ارائه میکند. کاربر میتواند توالی عددی بسازد، مقدار جمعی آن را مشاهده کند، توالی را کپی کند و هر نشانه را در مبدل یا نشانهنامه بررسی کند.
سامانه بهدرستی مشخص میکند که محاسبهٔ مقدار دهدهی، یک ابزار آموزشی است و جایگزین تفسیر کتیبهای نمیشود. این نکته مهم است؛ زیرا معنای یک توالی عددی در متن تاریخی فقط به جمع ریاضی نشانهها محدود نیست و باید در بافت کتیبه، ساختار نوشتار و وضعیت حفظشدگی بررسی شود.
نوآوری این بخش در اختراع نشانههای عددی نیست؛ بلکه در اتصال اعداد به محیط مشترک فرهنگ، مبدل، نشانهنامه و پیکره قرار دارد.
هوش مصنوعی «زال»؛ لایهٔ تحلیل شناختی و زبانشناختی گراف دانش
شرکت دانشبنیان آریا هامان مهر پارسه اعلام میکند که در توسعهٔ لایهٔ هوشمند پارسیان دژ، از هوش مصنوعی زال برای تحلیل دادههای خط میخی پارسی باستان استفاده شده است.
هدف از این کاربرد آن است که دادههای کتیبهای تنها بهعنوان توالیهایی از نویسهها دیده نشوند، بلکه روابط میان نشانهها، واژهها، رخدادها، بافتها و مفاهیم نیز در گراف دانش قابل تحلیل باشند.
زال در این چارچوب به غنیسازی تحلیلهای شناختی و زبانشناختی کمک میکند؛ از جمله:
- شناسایی و سازماندهی روابط میان واژهها و صورتها؛
- تحلیل ساختاری دادههای متنی؛
- بررسی همرخدادی واژهها و مفاهیم؛
- کمک به پیوند صورتهای نوشتاری با مدخلهای دانشی؛
- کشف روابط قابل بررسی میان رخدادهای کتیبهای؛
- کمک به خوشهبندی مفهومی دادهها؛
- فراهم کردن زمینهٔ تحلیل شبکهای زبان کتیبهها؛
- ارائهٔ شواهد بیشتر برای فهم روابط معنایی؛
- کمک به توسعهٔ گراف دانش از سطح واژه به سطح مفهوم و بافت.
به بیان دیگر، زال در اولین گراف دانش خط میخی پارسی باستان - پارسیان دژ برای عبور از «نمایش متن» به سوی مدلسازی روابط دانشی و فهم بهتر ساختار مفهومی کتیبهها به کار گرفته شده است. این تحلیلها جایگزین تخصص زبانشناس، کتیبهشناس یا ایرانشناس نیستند؛ بلکه ابزارهایی برای سازماندهی شواهد، آشکارسازی روابط و تسهیل بررسی علمی در اختیار آنان قرار میدهند.
زال یکی از فناوریهای هوش مصنوعی متعلق به شرکت دانشبنیان آریا هامان مهر پارسه است. پلتفرم رخشای، زال را بهعنوان دستیار متنی برای پردازش، تحلیل و تولید زبان معرفی میکند و زیرساخت دانشبنیان Rakhshai Graph-based NLP شرکت نیز بر تبدیل متن به ساختارهای گرافی، تحلیل ساختاری و کاربردهای گراف دانش تمرکز دارد. کلیهٔ حقوق مادی و معنوی رخشای و فناوریهای وابسته به آن متعلق به شرکت دانشبنیان آریا هامان مهر پارسه اعلام شده است.
استفاده از زال در پارسیان دژ، پیوندی میان دو مسیر تخصصی شرکت ایجاد کرده است: مسیر پژوهش میراث زبانی ایران و مسیر توسعهٔ هوش مصنوعی و پردازش گرافمحور زبان.
هوش مصنوعی «هامان آوا»؛ دسترسی صوتی به واژهها و کتیبهها
پارسیان دژ به هوش مصنوعی اختصاصی «هامان آوا» مجهز شده است. هامان آوا، سامانهٔ هوشمند تولید و ارائهٔ خوانش صوتی متعلق به شرکت دانشبنیان آریا هامان مهر پارسه است و برای در دسترس قرار دادن واژهها، خطوط و کتیبههای پارسی باستان بهصورت صوتی به کار میرود و اختصاصی برای این کارکرد طراحی شده است.
در مدخلهای فرهنگ واژه، کاربر میتواند خوانش تقریبی صورت آوانویسیشده را بشنود. در صفحات کتیبهها نیز امکان ارائهٔ خوانش کامل و خوانش خطبهخط فراهم شده است. برای نمونه، صفحهٔ کتیبهٔ DB1 بیستون یک خوانش کامل بیش از شانزده دقیقهای و خوانشهای جداگانهٔ خطوط را ارائه میکند. سامانه صریحاً اعلام میکند که این خوانشها مصنوعی و تقریبیاند و تلفظ تاریخی باید در فرایند علمی بازبینی شود.
یکی از مهمترین ویژگیهای هامان آوا، نحوهٔ انتقال عدمقطعیتهای متن به تجربهٔ شنیداری است. در خوانش صوتی:
- بخش مفقود یا ناخوانا با یک نشانهٔ صوتی و اعلان مشخص معرفی میشود؛
- پیش از بخش بازسازیشده، به شنونده اعلام میشود که خوانش بعدی یک بازسازی احتمالی است؛
- مکثها برای تفکیک بخشهای خوانش به کار میروند؛
- طول مکث بهعنوان تعداد واژههای افتاده تفسیر نمیشود؛
- تقریبیبودن تلفظ تاریخی پنهان نمیماند.
در راهنمای صوتی انگلیسی سامانه، برای بخشهای افتاده یا ناخوانا از اعلان «This part is missing or unreadable» و برای بازسازی پیشنهادی از اعلان «Possible reconstructed reading» استفاده میشود.
این رویکرد سه مزیت مهم ایجاد میکند:
دسترسپذیری
کاربرانی که خواندن نویسههای میخی یا آوانویسی علمی برایشان دشوار است، میتوانند از کانال صوتی برای آشنایی با ساختار واژهها و کتیبهها استفاده کنند.
آموزش
دانشجو میتواند همزمان شکل میخی، نویسهگردانی، آوانویسی، معنی و خوانش صوتی را مشاهده و مقایسه کند.
شفافیت پژوهشی
متن بازسازیشده یا آسیبدیده بدون هشدار مانند متن کاملاً حفظشده خوانده نمیشود. در نتیجه، عدمقطعیت ویراستاری در کانال صوتی نیز حفظ میشود.
شرکت دانشبنیان آریا هامان مهر پارسه اعلام میکند که توسعهٔ هامان آوا ادامه دارد و بهزودی خروجیهای بهبودیافتهتری برای خوانش واژهها و کتیبهها در اختیار پژوهشگران قرار خواهد گرفت. نسلهای آیندهٔ این فناوری با تکیه بر ارزیابی فنی، بازخورد پژوهشگران و توسعهٔ دادههای زبانی، مسیر دسترسی صوتی به متون باستانی را گسترش خواهند داد.
منشأ داده، قابلیت ممیزی و تفکیک لایههای پژوهشی
یکی از اصول اساسی اولین گراف دانش خط میخی پارسی باستان - پارسیان دژ، شفافیت دربارهٔ منشأ داده است. سامانه میان پنج حوزه تفاوت قائل میشود:
- دادهٔ متنی دریافتشده از منبع؛
- نرمالسازی فنی؛
- پردازش و تحلیل ماشینی؛
- دادهها و توضیحات تولیدشده؛
- بازبینی و اصلاح انسانی.
در روششناسی گراف دانش خط میخی پارسی باستان - پارسیان دژ، متن منبع شامل خط میخی، نویسهگردانی، آوانویسی، شناسههای کتیبه و محل خطوط است. فاصلهگذاری، جداکنندهها و صورتهای قابل جستوجو بهصورت جداگانه نرمالسازی میشوند. توکنسازی نیز میان واژه، واژهنگار، عدد، جداکننده و نشانهٔ ویراستاری تفاوت میگذارد.
پیوندهای فرهنگ واژه نیز میتوانند دارای وضعیتهای متفاوت باشند:
- تطبیق خودکار؛
- تطبیق استنباطی؛
- تطبیق بازبینیشده؛
- تطبیق دقیق؛
- پیشنهاد نزدیک؛
- تقریب آوایی.
روش تطبیق و سطح اطمینان همراه با نتیجه نگهداری میشود. ترجمهها یا توضیحات انگلیسی تولیدشده نیز تا زمانی که جایگزین بازبینیشدهٔ انسانی برای آنها تأیید نشده باشد، با برچسب «Machine-generated and unreviewed» نمایش داده میشوند.
نسخهٔ عمومی پیکرهٔ بررسیشده تاریخ انتشار ۱۵ اوت ۲۰۲۶، تعداد ۱۴۳ کتیبه، ۱٬۶۲۷ خط و اثرانگشت دادهٔ مشخص دارد. مبدل نیز نسخهٔ انتشار پیکره، نسخهٔ parser و hash منبع را همراه نتیجه نمایش میدهد.
این اطلاعات به پژوهشگر اجازه میدهد پاسخ سامانه را نه فقط مشاهده، بلکه منشأ و فرایند تولید آن را نیز بررسی کند.
همکاری علمی، استفادهٔ مجاز از دادههای TITUS و قدردانی رسمی
پیکرهٔ پارسی باستان TITUS یکی از منابع علمی و زبانشناختی مهم اولین گراف دانش خط میخی پارسی باستان - پارسیان دژ است. استفاده از دادههای TITUS برای ذخیرهسازی، پردازش و نمایش عمومی غیرتجاری در پارسیان دژ با اجازهٔ کتبی پروژهٔ TITUS انجام شده است.
پیکرهٔ رسمی TITUS بر پایهٔ ویرایشهای رولاند جی. کنت، مانفرد مایرهوفر و رودیگر اشمیت تنظیم شده است. دادهها توسط پژوهشگران مختلف وارد و تکمیل شدهاند؛ پروفسور یوست گیپرت و گوتس کیدانا افزودهها و بهبودهایی ارائه کردهاند و نسخهٔ TITUS توسط یوست گیپرت، خاویر مارتینس گارسیا و محمود اسناعشاری تهیه شده است. متن رسمی TITUS همچنین از افزوده شدن آوانویسی و تبدیل خط میخی به Unicode توسط عادل سرحدی و محمود اسناعشاری یاد میکند.
شرکت دانشبنیان آریا هامان مهر پارسه مراتب سپاس خود را از پروفسور یوست گیپرت برای اعطای اجازهٔ استفاده از دادههای پیکرهٔ پارسی باستان TITUS و ارائهٔ بازخورد علمی ارزشمند اعلام میکند. همچنین از پروژهٔ TITUS، تمامی مشارکتکنندگان آن و دانشگاه گوته فرانکفورت برای نقشی که در دسترسپذیر ساختن این منابع زبانشناختی برای مطالعه و آموزش داشتهاند، قدردانی میکنیم.
متن رسمی قدردانی مورد استفادهٔ شرکت به زبان انگلیسی چنین است:
“We gratefully acknowledge Professor Jost Gippert for kindly granting permission to use data from the TITUS Old Persian Corpus and for his valuable scholarly feedback. We also express our appreciation to the TITUS Project, its contributors, and the University of Frankfurt for their contribution to making these linguistic resources accessible for study and education.”
پروفسور یوست گیپرت در حال حاضر در دانشگاه هامبورگ ریاست پروژهٔ DeLiCaTe را بر عهده دارد و همچنان در زمینهٔ مطالعات زبانشناختی و فرهنگهای نوشتاری فعالیت میکند.
نخستین پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ محصول مستقل شرکت دانشبنیان آریا هامان مهر پارسه است. دادهها و متون پایهٔ متعلق به TITUS و دیگر منابع، حقوق مستقل خود را حفظ میکنند؛ در مقابل، طراحی، کد اختصاصی، الگوریتمها، معماری نرمافزار، گراف دانش، رابط کاربری، روشهای پردازش و ارائه، مستندات، هوش مصنوعی زال و هوش مصنوعی هامان آوا از دستاوردهای شرکت آریا هامان مهر پارسهاند.
جایگاه پارسیان دژ در مقایسه با پروژههای پیشین
برای تشخیص دقیق جایگاه نوآورانهٔ پارسیان دژ، باید میان «سابقهٔ دیجیتالسازی پارسی باستان» و «ایجاد یک پایگاه دانش یکپارچه با ترکیب کنونی» تفاوت گذاشت.
پیکرهٔ پارسی باستان TITUS
TITUS پیش از پارسیان دژ متن کتیبههای پارسی باستان را بهصورت دیجیتال، همراه با خط میخی، نویسهگردانی و آوانویسی عرضه کرده است. TITUS از بنیادیترین منابع علمی مورد استفاده در این حوزه است و یکی از پایههای دادهای نخستین پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ را تشکیل میدهد.
ارزش افزودهٔ پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ نسبت به متن پایه، ایجاد لایههای فرهنگ واژه، رخدادهای متصل، مبدل شواهدمحور، نشانهنامه، اعداد، وضعیت اطمینان و بازبینی، منشأ پردازش، هوش مصنوعی زال و دسترسی صوتی هامان آوا در یک محیط مشترک است.
Achaemenid Royal Inscriptions Online ــ ARIo
پروژهٔ ARIo در مجموعهٔ MOCCI تمام کتیبههای میخی شناختهشدهٔ پارسی باستان را دربر میگیرد و نسخههای منتشرشده توسط رودیگر اشمیت را دیجیتال و لماتیزه کرده است. ARIo همچنین دارای صفحات اطلاعاتی دربارهٔ فرمانروایان و برخی کتیبههاست.
این پروژه سابقهٔ مهمی در ایجاد پیکرهٔ حاشیهنویسیشده و لماتیزه دارد. تفاوت پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ در ترکیب فرهنگ، مبدل دوطرفه، پیکره، نشانهنامه، اعداد، شواهد رخدادی، وضعیت اطمینان و بازبینی و دو لایهٔ هوش مصنوعی زال و هامان آواست.
پروژهٔ DARIOSH
پروژهٔ بینالمللی DARIOSH از اوایل دههٔ ۲۰۰۰ برای بایگانی دیجیتال، تهیهٔ ویرایش جدید و تفسیر کتیبههای شاهی هخامنشی فعالیت داشته است. نام کامل آن Digital Achaemenid Royal Inscriptions Open Schema Hypertext است و دامنهٔ آن پژوهشهای عمیق کتیبهشناختی و نسخهشناختی هخامنشی را دربر میگیرد.
DARIOSH از پیشینههای مهم پژوهش دیجیتال کتیبههای هخامنشی است، اما هدف و معماری آن با ترکیب محصولی و پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ یکسان نیست. پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ بر اتصال تعاملی نشانه، واژه، رخداد، خط، کتیبه، ابزار تبدیل، صوت و وضعیت پردازش در یک محیط عمومی تمرکز دارد.
Old Iranian Online دانشگاه تگزاس
مجموعهٔ Old Iranian Online دانشگاه تگزاس درسهای پارسی باستان، فرهنگ صورتهای پایه، Master Glossary و نمایهٔ معنی انگلیسی ارائه میکند. این مجموعه از منابع آموزشی معتبر و مهم پارسی باستان است.
پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ در کنار کارکرد آموزشی، مدخلها را به شکل میخی، رخدادهای کامل پیکرهای، تحلیل نشانهای، وضعیت اطمینان، منشأ پردازش و خوانش صوتی متصل میکند.
Tuppime و CTML
Tuppime از سال ۲۰۰۰ خود را نخستین نمایشگر خط میخی در وب معرفی کرده و پایگاه آن شامل نشانههای پارسی باستان و ایلامی هخامنشی، ارزشهای خوانش و parser تبدیل متن به نشانه است. CTML نیز بهعنوان یک زبان نشانهگذاری XML برای تبادل متون میخی طراحی شده بود.
در نتیجه، نمایش خط میخی در وب، پیوند نشانه و خوانش و تبدیل نویسهگردانی به نشانه پیش از پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ سابقه داشته است. نوآوری پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ در تبدیل همین نوع قابلیتها به بخشی از یک گراف دانش شواهدمحور و متصل به فرهنگ، پیکره، رخدادها، اعداد، صوت و هوش مصنوعی است.
استاندارد Unicode
Unicode پیشتر پنجاه نویسهٔ پارسی باستان، شامل نشانههای آوایی، واژهنگارها، جداکننده و اعداد را تعریف کرده است. Unicode یک استاندارد رمزگذاری نویسه است و نه پیکره یا پایگاه دانش زبانشناختی.
پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ اطلاعات Unicode را به ارزش خوانش، نوع نشانه، واژهها، مبدل و نمونههای واقعی پیکرهای متصل میکند.
ویکیداده
ویکیداده بهعنوان یک گراف دانش عمومی، موجودیتی برای خط میخی پارسی باستان دارد و آن را به مفاهیمی مانند خط میخی، زبان پارسی باستان، جهت نوشتار، محدودهٔ Unicode و شناسهٔ ISO 15924 متصل کرده است.
اما این موجودیت عمومی با یک گراف دانش تخصصی در سطح نشانه، واژه، رخداد، خط، کتیبه، منشأ داده، اطمینان، بازبینی و صوت تفاوت دارد.
چرا پارسیان دژ «نخستین» است؟
بر پایهٔ بررسی تطبیقی منابع عمومی و دانشگاهی قابلدسترسی تا سپتامبر ۲۰۲۶، شرکت دانشبنیان آریا هامان مهر پارسه، پایگاه دانش یکپارچهٔ خط میخیِ پارسی باستان - پارسیان دژ را بهعنوان:
نخستین پایگاه دانش یکپارچه، شواهدمحور و هوشمصنوعیپشتیبانِ اختصاصیافته به زبان و خط میخی پارسی باستان
معرفی میکند.
«نخستینبودن» در این عنوان به وجود جداگانهٔ فرهنگ واژه، پیکره، جدول Unicode، نمایشگر خط میخی یا ابزار نویسهگردانی اشاره ندارد؛ زیرا هر یک از این حوزهها پیشینهٔ ارزشمند دانشگاهی و فنی دارند.
وجه نخستین پارسیان دژ در ترکیب همزمان و معماری پیوندی اجزای زیر است:
- فرهنگ واژهٔ متصل به شواهد کتیبهای؛
- مبدل دوطرفهٔ مبتنی بر دادههای مستند؛
- پیکرهٔ خطبهخط و جستوجوپذیر؛
- پیوند واژه به رخداد دقیق در پیکره؛
- تحلیل نشانهبهنشانه؛
- نشانهنامهٔ Unicode متصل به کاربرد واقعی؛
- ابزار ساخت و بررسی اعداد؛
- مدل ارتباطی نشانه، واژه، رخداد، خط و کتیبه؛
- نگهداری منشأ داده و نسخهٔ پردازش؛
- نمایش روش تطبیق و سطح اطمینان؛
- تفکیک خروجی ماشینی و بازبینی انسانی؛
- مدیریت صریح افتادگی، آسیب و بازسازی؛
- استفاده از هوش مصنوعی زال برای تحلیل شناختی و زبانشناختی گراف دانش؛
- استفاده از هوش مصنوعی هامان آوا برای دسترسی صوتی به واژهها و کتیبهها؛
- انتقال عدمقطعیت متن به تجربهٔ صوتی؛
- قرار دادن تمامی این لایهها در یک محیط پژوهشی اختصاصی پارسی باستان.
TITUS پیکرهٔ بنیادی و معتبر ارائه کرده است؛ ARIo کتیبهها را لماتیزه و حاشیهنویسی کرده؛ DARIOSH بایگانی و ویرایش علمی کتیبههای هخامنشی را دنبال کرده؛ Old Iranian Online منابع آموزشی و واژهنامهای ایجاد کرده؛ Tuppime نمایشگر و parser خط میخی ساخته؛ Unicode نویسهها را استاندارد کرده و ویکیداده اطلاعات عمومی را در گراف دانش خود قرار داده است. در منابع بررسیشده، سامانهٔ دیگری مشاهده نشد که تمام ترکیب یادشده را همراه با تحلیل شناختی زال و دسترسی صوتی هامان آوا در یک پایگاه دانش اختصاصی پارسی باستان گرد آورده باشد.
ازاینرو، عنوان «نخستین پایگاه دانش یکپارچه و شواهدمحور زبان و خط میخی پارسی باستان» عنوانی قوی، دقیق و متناسب با ماهیت نوآوری پارسیان دژ است.
طراحی آگاه از عدمقطعیت
یکی از ویژگیهای علمی پارسیان دژ این است که عدمقطعیت را پنهان نمیکند. در بسیاری از سامانههای عمومی، نتیجهٔ قطعی و نتیجهٔ استنباطی بهشکل مشابه نمایش داده میشوند. در پارسیان دژ، تفاوت میان این وضعیتها قابل مشاهده است:
- تطبیق دقیق و پیشنهاد نزدیک؛
- شاهد تاریخی و تقریب آوایی؛
- دادهٔ منبع و نرمالسازی؛
- تحلیل خودکار و نتیجهٔ بازبینیشده؛
- ترجمهٔ ماشینی و ترجمهٔ تأییدشده؛
- واژهٔ حلشده و حلنشده؛
- متن حفظشده و بخش افتاده؛
- متن اصلی و بازسازی ویراستاری؛
- تلفظ تقریبی و خوانش بازبینیشده.
روششناسی سامانه تصریح میکند که جستوجو ابتدا صورت کامل و مستند را بررسی میکند و پیشنهاد نزدیک یا تقریب آوایی را بهجای گواه تاریخی یا ترجمه معرفی نمیکند. آسیب، بازسازی و کاملبودن متن نیز تنها با رنگ نشان داده نمیشود و وضعیت آن بهصورت متنی ثبت میشود.
این رویکرد، اعتماد پژوهشی را تقویت میکند؛ زیرا کاربر فقط پاسخ دریافت نمیکند، بلکه از وضعیت و درجهٔ اتکاپذیری آن نیز آگاه میشود.
کاربردهای پژوهشی پارسیان دژ
پارسیان دژ میتواند در چند حوزه مورد استفاده قرار گیرد:
زبانشناسی تاریخی
پژوهشگر میتواند صورتهای واژگانی، رخدادها، تنوع نوشتاری، ساخت نشانهای و بافت کتیبهای را در کنار یکدیگر بررسی کند.
کتیبهشناسی دیجیتال
خطوط کتیبهها همراه با شناسه، وضعیت ویراستاری، افتادگی، بازسازی، نشانهها و منابع در دسترساند.
واژهنگاری رایانشی
فرهنگ واژه به رخدادهای پیکرهای متصل شده و امکان بررسی کاربرد واقعی صورتها را فراهم میکند.
پردازش زبانهای باستانی
دادههای توکنشده، روابط گرافی، سطح اطمینان و نسخههای پردازش میتوانند زمینهٔ توسعهٔ روشهای محاسباتی را فراهم کنند.
تحلیل شناختی و مفهومی
هوش مصنوعی زال امکان بررسی روابط میان واژهها، بافتها و مفاهیم را در قالب گراف دانش تقویت میکند.
آموزش دانشگاهی
مدرس میتواند شکل میخی، نویسهگردانی، خوانش، معنی، تحلیل نشانهای، شاهد کتیبهای و صوت را در یک محیط نمایش دهد.
آموزش عمومی
کاربر غیرمتخصص میتواند از معنی یک واژه وارد ساختار نشانهای و کتیبهٔ واقعی شود و مسیر تولید دانش را مشاهده کند.
دسترسپذیری
هامان آوا امکان استفادهٔ صوتی از واژهها و کتیبهها را گسترش میدهد و وضعیت بخشهای افتاده یا بازسازیشده را نیز بهصورت شنیداری منتقل میکند.
میراث فرهنگی دیجیتال
پارسیان دژ بخشی از میراث زبانی و نوشتاری ایران را در قالبی ساختاریافته، استاندارد و قابل جستوجو برای نسل امروز و آینده حفظ میکند.
مالکیت فناوریها و تفکیک حقوق منابع
هوش مصنوعیهای زال و هامان آوا، معماری نرمافزار، گراف دانش، کدهای اختصاصی، الگوریتمها، روشهای پردازش و ارائه، رابط کاربری و مستندات پارسیان دژ متعلق به شرکت دانشبنیان آریا هامان مهر پارسهاند.
در مقابل، حقوق دادهها، متون و منابع پایهٔ متعلق به TITUS، دانشگاهها، پژوهشگران، ناشران، عکاسان یا دیگر دارندگان حقوق، مستقل باقی میماند. پارسیان دژ از دادههای TITUS مطابق مجوز دریافتشده استفاده میکند و نام و منشأ منابع علمی را در نتایج مرتبط حفظ میکند.
این تفکیک روشن نشان میدهد که:
- دادهٔ علمی پایه با احترام به صاحبان آن استفاده شده است؛
- مجوز استفاده و قدردانی علمی بهصورت شفاف اعلام شده است؛
- ارزش افزودهٔ فنی، معماری، هوش مصنوعی و تجربهٔ پژوهشی توسط شرکت ایجاد شده است؛
- پارسیان دژ محصول مستقل شرکت دانشبنیان آریا هامان مهر پارسه است.
مسیر پیش رو
پارسیان دژ یک پروژهٔ ایستا نیست. شرکت دانشبنیان آریا هامان مهر پارسه توسعهٔ این زیرساخت را در چند مسیر ادامه خواهد داد:
- افزایش پوشش و عمق مدخلهای فرهنگ واژه؛
- گسترش بازبینی انسانی پیوندهای واژهنامهای و تحلیلها؛
- بهبود تحلیلهای شناختی و زبانشناختی هوش مصنوعی زال؛
- گسترش روابط مفهومی گراف دانش؛
- ارتقای خروجیهای صوتی هامان آوا؛
- ارائهٔ خوانشهای بهبودیافتهتر برای واژهها، خطوط و کتیبهها؛
- تکمیل اطلاعات صرفی و نحوی؛
- توسعهٔ ارتباط میان متن و تصاویر اصل کتیبهها؛
- تقویت ابزارهای پژوهشی و مقایسهای؛
- گسترش امکان استفادهٔ دانشگاهی و آموزشی؛
- حفظ نسخهبندی، منشأ داده و قابلیت ممیزی در تمام مراحل توسعه.
نسخههای آتی زال و هامان آوا پس از تکمیل آزمونهای فنی و دریافت بازخوردهای علمی، خروجیهای دقیقتر و غنیتری در اختیار محققان قرار خواهند داد.
نتیجهگیری
شرکت دانشبنیان آریا هامان مهر پارسه با افتخار اعلام میکند که پارسیان دژ، حاصل پیوند پژوهش تاریخی، زبانشناسی، مهندسی نرمافزار، گراف دانش، پردازش زبان و هوش مصنوعی ایرانی است.
نوآوری پارسیان دژ در آن نیست که منابع و پژوهشهای پیشین را نادیده بگیرد؛ بلکه در آن است که بر پایهٔ میراث علمی ارزشمند پروژههایی مانند TITUS، یک لایهٔ تازه و یکپارچه از دانش، شواهد، پردازش و دسترسی ایجاد کرده است.
در پارسیان دژ:
نشانه به واژه متصل است؛
واژه به شاهد کتیبهای؛
شاهد به خط؛
خط به کتیبه؛
کتیبه به منبع؛
منبع به نسخه و منشأ پردازش؛
و همهٔ این روابط به گراف دانش، تحلیل شناختی زال و خوانش صوتی هامان آوا پیوند میخورند.
بر پایهٔ بررسی تطبیقی منابع موجود، این ترکیب، پارسیان دژ را به نخستین پایگاه دانش یکپارچه، شواهدمحور و هوشمصنوعیپشتیبانِ زبان و خط میخی پارسی باستان تبدیل کرده است.
این دستاورد گامی در جهت حفاظت فناورانه از میراث زبانی ایران، توسعهٔ پژوهش دیجیتال، افزایش دسترسپذیری منابع باستانی و فراهم کردن زیرساختی ایرانی برای نسل جدید مطالعات زبانهای تاریخی است.
دربارهٔ شرکت دانشبنیان آریا هامان مهر پارسه
آریا هامان مهر پارسه یک شرکت دانشبنیان نرمافزاری ایرانی است که در زمینههای هوش مصنوعی، پردازش زبان طبیعی، تحلیل متن، گراف دانش، کلانداده و توسعهٔ زیرساختهای پژوهشی فعالیت میکند.
مسیر پژوهشی شرکت از سال ۱۳۹۰ با پارسیان دژ و پژوهش در تاریخ و دادههای ایران آغاز شد و در ادامه به توسعهٔ محصولات هوش مصنوعی فارسیمحور، از جمله رخشای، هوش مصنوعی زال، آزمایشگاه هوش مصنوعی هامان و دیگر زیرساختهای دانشی گسترش یافت.
پارسیان دژ، زال و هامان آوا از محصولات و فناوریهای متعلق به شرکت دانشبنیان آریا هامان مهر پارسهاند.
قدردانی علمی
شرکت دانشبنیان آریا هامان مهر پارسه بار دیگر از پروفسور یوست گیپرت برای اعطای اجازهٔ استفاده از دادههای پیکرهٔ پارسی باستان TITUS و بازخورد علمی ارزشمند ایشان سپاسگزاری میکند. همچنین از پروژهٔ TITUS، مشارکتکنندگان آن و دانشگاه گوته فرانکفورت برای نقشی که در دسترسپذیر کردن این منابع زبانشناختی برای مطالعه و آموزش داشتهاند، قدردانی میشود.
“We gratefully acknowledge Professor Jost Gippert for kindly granting permission to use data from the TITUS Old Persian Corpus and for his valuable scholarly feedback. We also express our appreciation to the TITUS Project, its contributors, and the University of Frankfurt for their contribution to making these linguistic resources accessible for study and education.”
هنوز دیدگاهی ثبت نشده است؛ نخستین گفتوگوی مستند را آغاز کنید.